1. OpenAIが発表した共通シグナル
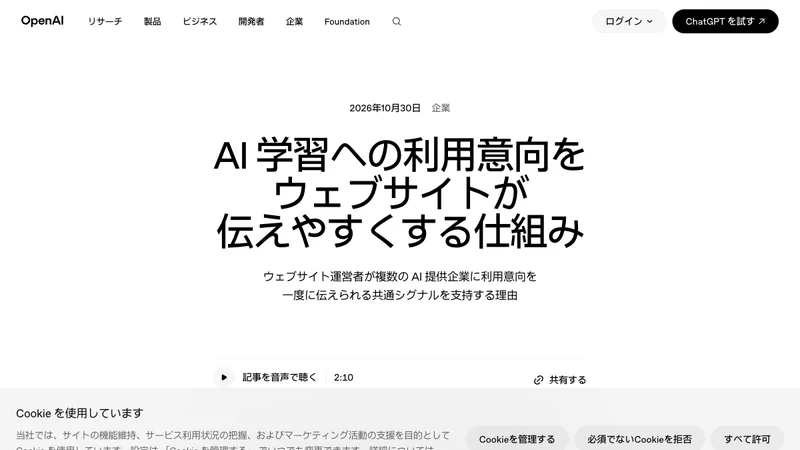
OpenAIは2026年10月30日、ウェブサイト運営者が生成AIの基盤モデル学習への利用意向を伝えるための、robots.txt上の共通シグナルを尊重する方針を発表しました。これまで提供企業ごとにクローラーを識別してルールを管理していた運営者が、複数の参加事業者へ同じ意向を伝えやすくするための取り組みです。
重要なのは、これは「今すぐ一行追加すれば、すべてのAIへの扱いが確定する」という発表ではないことです。OpenAIは今後数か月での実装を目指すとし、既存のrobots.txtによるクローラー制御も引き続き適用・尊重すると説明しています。具体的な運用や対応範囲は、実装詳細の公開後に確認する必要があります。
2. AI学習・閲覧・引用は別の話
「AIに使われる」という言葉には、少なくとも三つの場面があります。第一に、基盤モデルを訓練するためにコンテンツを使うこと。第二に、検索や回答生成の時点でページを見にいくこと。第三に、利用者への回答でサイト名やリンクを根拠として示すことです。目的も技術的な経路も異なるため、一つの設定だけで一律に判断できるとは限りません。
| 場面 | 運営者が確認すること | 混同しないための見方 |
|---|---|---|
| AI学習 | 基盤モデル訓練への利用意向 | 今回の共通シグナルが対象とする中心領域 |
| 検索・閲覧 | 検索用クローラーや公開範囲 | 検索結果に出ることと学習利用は別 |
| 回答での引用 | 質問への適合性、情報の明確さ、公開状態 | 引用を保証する設定ではなく、回答時の判断に左右される |
したがって「学習利用を控えてほしい」という意向と、「ユーザーが会社を探したときは正確な公式情報を見てほしい」という意向は、両立し得ます。設定を変える前に、どの利用を許可・制限したいのか、サイトの目的を文章にして分けましょう。
3. 実際に検索・質問されること
AI活用に不慣れな人は「robots.txt AI 学習 拒否」「ChatGPTに自分のサイトを学習させない方法」「AIに会社情報を出さない方法」と検索し、設定の有無を先に知りたがります。一方、日常的にAIを使う担当者は、ChatGPTやGeminiに「福岡の中小企業向けAI研修会社を、公式サイトを根拠に比較して」「このサービスの料金・対象・できないことを、出典URL付きで整理して」と聞くでしょう。
後者の回答でAIが探しやすいのは、サービスの対象、提供内容、価格または見積条件、対応地域、更新日が近い場所にある一次情報です。派手な宣伝文だけのページより、「誰に何を提供し、どの条件では対応できないか」が確認できるページの方が、人にもAIにも使いやすくなります。ただし、内容を整えても、個々のAIや質問で引用されることは保証できません。
4. AIが根拠にしやすい記事の条件
「AIに引用される記事」を作る目的は、機械をだますことではありません。質問された人が、結論と根拠をたどれる状態を作ることです。たとえば新しい制度や製品機能を説明するなら、発表元、公開日、対象プラン、利用できる地域、分からない点を分けます。主張だけで終わらせず、公式ページへのリンクを置くと、読者が更新後の情報も確認できます。
AIに、自社に関する回答を確認させる質問例

「[会社名]の[サービス名]について、公式サイトだけを使い、
対象者・できること・料金または見積条件・導入までの流れを整理してください。
各項目にURLを付け、公式情報で確認できないことは推測せず
『要確認』と書いてください。情報の更新日も示してください。」この質問で出た回答は、掲載順位や正確性の採点ではありません。リンク先を実際に開き、古い料金、別サービスの説明、対象外の地域が混ざっていないかを見るための点検材料です。AIの出典確認は、ChatGPTの調査結果を鵜呑みにしない3つの質問も参考にしてください。
5. 今、サイト運営者が決めること
最初に行うべきは、検索順位だけを理由にrobots.txtを編集することではありません。①学習利用についての方針、②検索・閲覧を必要とする公開ページ、③社外に出してよい情報、④回答に使われたときも正確であってほしい公式ページ、を担当者間で決めます。著作物、会員限定ページ、顧客情報を含む資料は、公開設定そのものから確認してください。
その上で、各AI提供者の公式ドキュメントと、利用中のCMSや配信基盤の仕様を確認します。今回の共通シグナルは実装予定段階なので、未確定の記述をコピーして本番設定へ入れるのは避けるべきです。公開情報を整える作業は、AIに選ばれる記事の作り方、設定とコンテンツを一緒に点検する際は構造化データとLLMO対策もあわせてご覧ください。
MIRAINAの視点:AIに関する設定は「許可するか、拒否するか」の二択に見えますが、実務では用途ごとに情報を分ける設計が重要です。自社が出すべき公式情報を先に整え、学習・閲覧・引用の目的を分けて判断すれば、後から設定を見直すときにも迷いにくくなります。
6. まとめ
OpenAIが発表したrobots.txtの共通シグナルは、基盤モデル学習への利用意向を複数のAI提供者に伝えやすくする取り組みです。これは、検索で見つかることやChatGPTなどの回答で引用されることを直接決める仕組みではありません。まずは自社の利用方針を用途別に整理し、正確な公式ページを保ちましょう。設定の詳細が公開されたら、対象・時期・既存ルールとの関係を公式情報で確認してから対応することが安全です。