1. 何が公開された?MAI-Transcribe-2の概要
Microsoft AIは2026年9月3日、自社開発の音声テキスト変換モデル「MAI-Transcribe-2」を公開しました。Microsoft Foundry(Azure Speech)経由で利用でき、公式ドキュメントによれば60の言語と「実際のオーディオ条件」での高速かつ正確な文字起こしを提供します。日本語も対応言語に含まれています。
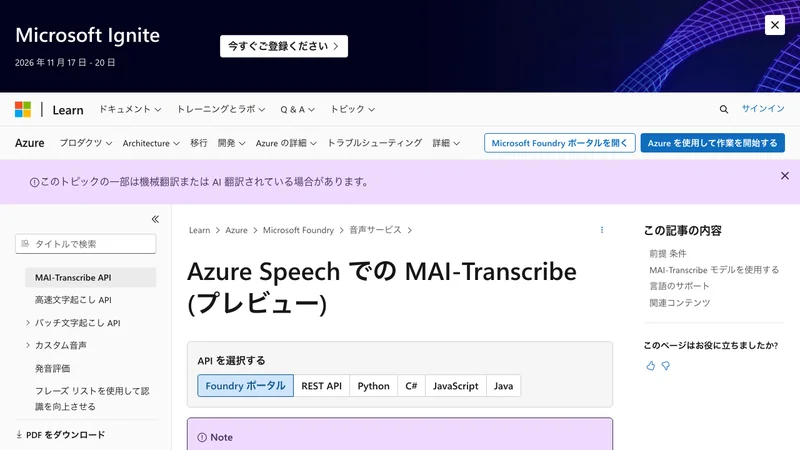
公式ドキュメントが想定ワークロードとして挙げているのは、ビデオキャプション、会議、臨床ノート、コールセンターのドキュメント、アクセシビリティツール、コンテンツ作成、音声エージェントです。提供される機能は次の通りです。
- 話者ダイアライゼーション(話者分離):録音を話者別にセグメント化し、各発言を話者に紐づける
- 単語レベルのタイムスタンプ:すべての単語に開始位置と長さを付与し、検索・編集を可能にする
- 自動言語識別:言語を指定しなくてもモデル側が判定する(既定は多言語モード)
- キーワードバイアス:商品名や略語などの用語リストを渡して認識を寄せる
- コードスイッチング:発話の途中で言語が切り替わる会話に対応する
- 文字起こしスタイルの切り替え:フィラーを含む「verbatim」と、フィラーを除いた読みやすい「clean」を選べる
なお公式ドキュメントでは、旧世代の MAI-Transcribe-1 が2026年8月20日付で非推奨となったことも明記されています。MicrosoftのMAIシリーズ全体の位置づけについてはMicrosoft独自AIモデルMAI発表の記事もあわせてご覧ください。
2. 精度・速度・価格を数字で確認する
今回の公開が注目されている理由は、精度・速度・価格の3つが同時に改善された点にあります。報道されている数値を整理します。
| 指標 | MAI-Transcribe-2 | 補足 |
|---|---|---|
| 精度(WER) | 60言語平均 5.2% | FLEURSベンチマーク。比較対象中トップ |
| 処理速度 | 最大10倍 | GPT-Transcribe比。Scribe v2比7倍、Gemini 3.5 Transcribe比5倍 |
| 価格 | 音声1時間 0.10ドル | 2026年12月31日までの期間限定価格 |
| 前世代価格 | 音声1時間 0.36ドル | 今回の価格は約72%の引き下げにあたる |
| 対応言語 | 60言語 | 日本語を含む |
WERは「話した単語のうち何%を誤認識したか」を示す指標で、小さいほど高精度です。60言語の平均で5.2%という水準は、Whisper-Large-V3、GPT-Transcribe、Scribe v2、Gemini 3.5 Transcribeといった主要モデルと比較してトップと報じられています。
ただし「WERが最も低い」という主張には読み方があります。これは60言語の平均値での比較であり、日本語単体での誤り率が同じ順位になるとは限りません。実務で判断すべきは公表されたベンチマークではなく、自社の会議音声で試した結果です。この点は後述の3ステップで触れます。
3. 中小企業の実務でどこに効くのか
音声認識の価格が下がることは、中小企業にとって「これまで採算が合わなかった記録業務」が現実的になることを意味します。特に効きやすいのは次の領域です。
- 会議・商談の議事録:録音を丸ごとテキスト化し、要約はLLMに渡す。話者分離があるため「誰が何を言ったか」まで残せる。
- 電話・問い合わせ対応の記録:コールセンター用途が公式の想定ワークロードに含まれており、ノイズの多い環境での堅牢性が設計に織り込まれている。
- 動画・セミナーの字幕:単語レベルのタイムスタンプがあるため、字幕ファイルの生成や検索に転用しやすい。
- 多言語対応:インバウンド接客や海外取引先とのやり取りで、自動言語識別とコードスイッチングが活きる。
コスト感の目安:週5時間の会議を録音すると月20時間、音声1時間0.10ドルなら月2ドル(1ドル150円換算で約300円)です。もちろんこれはモデル利用料のみで、Azure側のリソース費用や社内で構築・運用する手間は別途かかります。それでも「録音は全部残す」という運用が価格面では成立する水準になった、というのが今回の意味です。
なお、Google MeetやTeamsのようにグループウェア側に議事録機能が組み込まれている場合、そちらのほうが導入は圧倒的に簡単です。会議ツール内で完結させたい場合はGoogle MeetのAI議事録の記事もご確認ください。MAI-Transcribe-2が向くのは、既存の会議ツールでは拾えない音声(電話録音、対面商談のICレコーダー、動画素材)を自社の仕組みに取り込みたいケースです。
4. 使う前に確認する4項目
数字だけを見て導入を決めると足元をすくわれます。公式ドキュメントに明記されている制約のうち、実務に直結する4点を挙げます。
- パブリックプレビューである:公式ドキュメントは「このプレビューはサービスレベルアグリーメント(SLA)なしで提供され、運用環境のワークロードには推奨されません」と明記しています。基幹業務に組み込むのは時期尚早で、まずは検証用途に限定するのが妥当です。
- 話者分離は長時間の録音で失敗する:プレビュー時点では、話者分離を有効にした約15分以上の録音がタイムアウト系のエラー(HTTP 408 / 500 / 503)で失敗すると公式に注意書きがあります。長時間の会議では話者分離をオフにして文字起こしし、返却された単語レベルのタイムスタンプを使って別途話者を割り当てるのが公式の推奨回避策です。
- 0.10ドルは期間限定価格:この価格は2026年12月31日までとされています。年明け以降の価格は現時点で確定していないため、コスト試算を年間予算に落とし込む際は注意が必要です。
- 既定の出力スタイルは「verbatim」:既定では「えー」「あの」といったフィラーや言い直しがそのまま残ります。読ませる議事録を作るなら
cleanを指定し、コンプライアンスや品質保証で発言を正確に残す必要があるなら既定のままにする、という使い分けになります。
もう1点、言語指定には注意があります。公式ドキュメントは locales パラメータについて「モデルに対する非常に強力なヒントであり、録音が特定の言語であると絶対に確信している場合を除き、指定しないでください」と述べています。日本語の会議だからといって反射的に ja を固定すると、英語混じりの発言で精度を落とす可能性があります。
5. 今日から試す3ステップ
MIRAINAの提案:プレビュー段階の技術に対して正しい向き合い方は、「全社導入の検討」ではなく「自社音声での実測」です。
- 15分以内の録音1本で試す:話者分離の制約に引っかからない長さで、実際の会議音声を1本流す。ベンチマークの5.2%ではなく、自社の音声環境での精度を自分の目で確認する。
- 用語リストを渡して再測定する:自社の商品名・社内略語・取引先名をキーワードバイアス(
phraseList)に登録して同じ音声を再実行し、差分を見る。固有名詞の誤認識は議事録の実用性を最も下げる要因で、ここが改善するかどうかが導入判断の分かれ目になります。 - 人が確認する範囲を先に決める:「文字起こしはAI、事実確認と共有は人」のように責任の境界を決めてから運用に乗せる。WER5.2%は100単語に約5語の誤りが残るということであり、無編集で社外に出せる品質ではありません。
この進め方は、AI導入全般に共通する考え方でもあります。中小企業のAI活用が伸び悩む背景については帝国データバンク調査の記事で整理しています。自社業務に合わせた検証設計や社内ルールづくりは、生成AI活用支援やAI研修でご支援しています。
6. まとめ
MAI-Transcribe-2は、60言語平均WER5.2%・GPT-Transcribe比で最大10倍の処理速度・音声1時間0.10ドルという3拍子が揃ったモデルです。価格が前世代から約72%下がったことで、これまで費用対効果が合わなかった「すべての音声を記録に残す」運用が、少なくともコスト面では射程に入りました。
一方で、パブリックプレビューであること、話者分離が約15分以上の録音で失敗すること、0.10ドルが2026年末までの期間限定価格であることは、見出しの数字だけでは見えない前提です。中小企業がいま取るべき行動は、全社導入の意思決定ではなく、15分の自社音声で実測して固有名詞の精度を確かめることです。その1本の検証が、年明けの正式提供時に慌てないための最短ルートになります。