1. 何が発表された?Data agentの概要
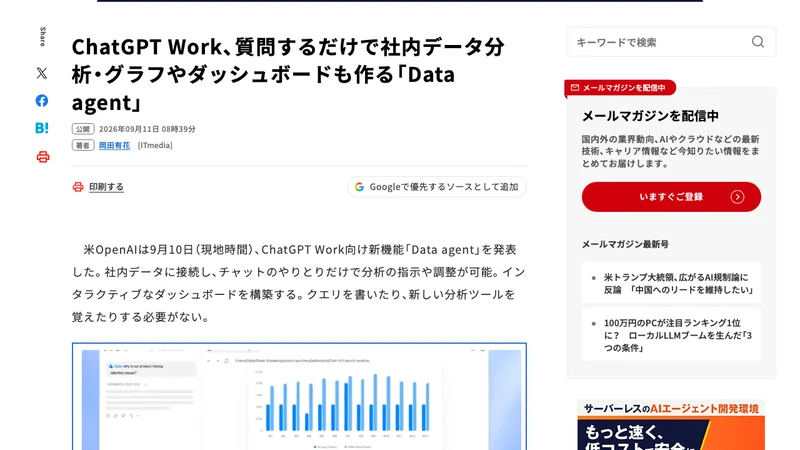
OpenAIは2026年9月10日(現地時間)、ChatGPT Work向けの新機能「Data agent」を発表しました。承認された社内データソースに接続し、業績指標に何が起きたのかを調査して、社員が共有できるインタラクティブなダッシュボードを構築するプラグインです。
OpenAIが想定しているのは、「なぜ売上が鈍ったのか」「どこで支出が増えているのか」「大口顧客のどの課題が契約更新を脅かしているのか」といった日常的な業務上の問いです。こうした問いはこれまで、レポートが出てくるのを待つか、分析できる人に依頼するしかありませんでした。
Data agentの特徴は、ユーザーがSQLなどのクエリを書かず、新しい分析ツールの使い方を覚える必要もなく、1つの会話の中で分析を指示し、調整していける点にあります。「この数字を部門別に分けて」「先月と比べて」といった追加の問いを重ねながら、分析を深めていく使い方が想定されています。提供形態は、企業向けワークスペース「ChatGPT Work」のプラグイン(ディレクトリ上の名称は「Data」)です。
2. 何につながり、どこにダッシュボードを作れるのか
実務判断で重要なのは「自社の環境とつながるのか」です。発表された接続先を整理しました。
| 区分 | 対応している主なサービス |
|---|---|
| データソース接続 | Amazon Redshift、Datadog、Google BigQuery、ClickHouse、Databricks、MongoDB、Snowflake など |
| ファイル・文書の取り込み | Google ドライブ、SharePoint |
| ビジネス定義の参照元 | dbt、Snowflake Horizon、Databricks Genie Ontology、GitHub、既存のBIダッシュボード |
| ダッシュボード作成先 | Omni、Oracle BI、Power BI、Sigma、Tableau、ThoughtSpot |
| 分析結果の共有 | Slack、メール |
見落とされがちですが、重要なのは3行目の「ビジネス定義の参照元」です。Data agentは単に数字を読むのではなく、その企業独自のビジネス用語、指標の定義、計算式、データ同士の関係を使ってデータを解釈します。これらの定義は、dbtやSnowflake Horizon、Databricks Genie Ontologyといったセマンティックレイヤーや既存のBIダッシュボードから読み込まれます。
つまり、「自社にとって『売上』が何を指すのか」が定義されていない会社では、Data agentの精度は上がりません。AIの性能ではなく、自社のデータ整備状況が結果を左右する構造になっています。
権限管理については、管理者がどのデータ接続を利用可能にするか、どの役割のユーザーが使えるかを決めます。実行されるクエリは、接続されたアカウントの既存の権限(テーブル単位・行単位・列単位の制限を含む)に従うため、その社員が本来アクセスできないデータをData agentが勝手に読むことはないという設計です。AIエージェントの統制についてはSalesforceのAI Control Planeの記事もあわせてご覧ください。
また分析して終わりではなく、次に取るべき手順や関わるべき人物を提案し、Slackやメールで結果を共有し、ユーザーが承認した作業を連携ツール経由で実行するところまでが射程に入っています。
3. 先行導入企業で実際に何が起きたか
OpenAIは自社内の状況として、プロダクトチームのほぼ全員、市場開拓(go-to-market)組織の3分の2以上がChatGPT Workでdata agentsを使っていると述べています。同社はこの浸透の要因を、社内データチームが共通のビジネス定義を整備し、アクセスルールを定め、機微データへの安全策を講じたことに帰しています。
社外でも、αプログラム参加企業の事例が公表されています。日本企業ではNTTデータが名を連ねています。
- NTTデータ:同社グループのGlobal AI Office責任者(Yuji Shono氏)は、ライセンス費用・工数・技術的な専門性がダッシュボードの全社展開を阻んでいたとしたうえで、「特に営業部門やコーポレート部門の多くの非エンジニアが、平易な言葉で自分のダッシュボードを構築・更新できるようになった」と述べています。
- ServiceTitan:同社のAIアシスタント「Atlas」の利用者が、非利用者の約3倍の頻度でキャンペーンを立ち上げていることを示すダッシュボードを構築。この発見がオンボーディングの簡素化につながったとしています。
- micro1:オペレーションチームが業績追跡用のダッシュボードを30分で再構築し、同時に元のダッシュボードに含まれていた誤りを発見したと報告されています。
ただし、これらはすべてOpenAIの発表資料に掲載された顧客の声である点は割り引いて読む必要があります。「30分で再構築」も「約3倍」も、すでにBigQuery級のデータ基盤とBI環境を持つ企業での数字であり、データが各担当者のExcelに散らばっている会社で同じ結果が出るわけではありません。
4. 社内データをつなぐ前に決める4項目
Data agentは「AIに社内の生データを読ませる」機能です。便利さと引き換えに、これまで曖昧にできていた論点が一気に表面化します。導入検討の前に決めておくべき4点を挙げます。
- 前提となるプラン要件を確認する:Data agentはChatGPT Workの機能であり、企業向け契約と管理者による有効化が前提です。個人向けプランの延長線上で使えるものではありません。
- 「誰がどのデータに触れてよいか」を先に決める:Data agentは接続アカウントの既存権限に従います。裏を返せば、現在の権限設定がそのままAIの閲覧範囲になるということです。「実は全社員が給与テーブルを参照できた」といった不備はそのまま露出します。接続前に権限の棚卸しを行うのが順序です。
- 指標の定義を1つに揃える:「売上」が受注ベースなのか計上ベースなのか、「アクティブユーザー」の定義は何か。この合意がない状態でAIに問いかけても、返ってくる数字を誰も信用できません。OpenAI自身が社内浸透の要因に「共通のビジネス定義の整備」を挙げている点は示唆的です。
- 出てきた数字を誰が検証するかを決める:自然言語で分析できることは、裏付けなしに数字が独り歩きするリスクと表裏一体です。経営判断に使う数字については、人が一次データに当たって確認する工程を残してください。
中小企業のAI活用が試用段階で止まりやすい構造的な背景については帝国データバンク調査の記事で整理しています。
5. 中小企業が今日から始める3ステップ
MIRAINAの提案:Data agentはデータ基盤が整った企業ほど効果が大きい機能です。中小企業にとっての正しい問いは「導入するか」ではなく、「この種の機能が来たときに使える状態に自社があるか」です。今すぐ着手できるのは次の3つです。
- 主要指標を10個、紙に書き出して定義を確定させる:売上、粗利、新規顧客数、リピート率など、経営会議で使う数字を列挙し、それぞれ「どのデータから、どう計算するか」を1行で書く。ここで社内の認識がずれていることが判明するのが普通で、それ自体が最大の成果です。
- 数字がどこにあるかを1枚にまとめる:会計ソフト、POS、予約システム、スプレッドシート。データの置き場所と持ち主を可視化します。この棚卸しがないまま「AIでデータ分析」に進むと、必ず「そもそもデータが集まらない」で止まります。
- 今ある範囲でAIに分析させてみる:大規模なデータ基盤がなくても、CSVを書き出してChatGPTやGeminiのデータ分析機能に読ませることは今日からできます(Android版SheetsのGeminiで売上表を分析する記事)。ここで「何を聞けば示唆が出るか」の感覚を掴んでおくと、本格的な仕組みを入れる際の判断が速くなります。
指標の定義づくりやデータ整備の進め方、社内ルールの設計は、生成AI活用支援やAI研修でご支援しています。
6. まとめ
ChatGPT WorkのData agentは、BigQueryやSnowflakeといった社内データ基盤に接続し、クエリを書かずに会話だけで分析を進め、Power BIやTableauの中にまでダッシュボードを作れる機能です。管理者が接続先と利用権限を統制し、クエリは既存のアクセス権限に従います。
注目すべきは、OpenAI自身が社内浸透の理由として「共通のビジネス定義の整備、アクセスルールの策定、機微データへの安全策」を挙げている点です。この機能の成否を決めるのはAIの性能ではなく、つなぐ側のデータが整っているかどうかでした。中小企業がいま取るべき行動は、高機能なエージェントの導入検討ではなく、主要指標10個の定義を確定させ、データの置き場所を1枚にまとめることです。この地味な作業こそが、次に来るどのAI分析ツールにも効く唯一の準備になります。